Qu’est‑ce qu’un centre de données ou « data center » ? Pourquoi ces infrastructures soulèvent‑elles tant de débats ?
Le développement des usages du numérique s’appuie sur des centres de données ou data centers qui constituent le socle physique principal du monde numérique et de l’IA. Ils permettent, par exemple, le stockage sécurisé des transactions et des données des clients des banques, la diffusion de films et de séries en streaming, les jeux en ligne avec les questions de latence des temps de réponse, la gestion des interactions des réseaux sociaux en temps réel, l’archivage de photos ou de vidéos, les services numérisés de l’État et les enjeux de souveraineté, etc.
Michel Robert, Université de Montpellier
L’ESSENTIEL
- Les centres de calcul et de données sont des infrastructures critiques dans notre monde numérique. Leurs tailles et leurs capacités de calcul explosent, en lien avec l’essor de l’intelligence artificielle générative.
- De nombreux projets de constructions sont en cours, en France et à l’étranger.
- Mais à l’heure où leur rentabilité est questionnée, et où certains peinent à être alimentés avec suffisamment d’électricité, se posent des questions simples et néanmoins cruciales : que sont ces centres de données et de calculs, au juste ? De quoi dépendent-ils ?
Le terme data center se traduit en français par « centre de données » ou « centre de traitement des données » ou encore historiquement « centre informatique ». Mais, avec l’essor de l’IA (intelligence artificielle) et des besoins croissants en calcul haute performance, les infrastructures modernes ne se limitent plus au stockage de données : elles peuvent aussi intégrer des capacités massives de traitement et de calculs intensifs.
À strictement parler, il faudrait donc appeler ces infrastructures critiques « centres de données et de calcul » (CDC), ou bien en anglais, Compute and Data Center. Celles-ci sont ancrées dans le réel, ce qui contraste avec une perception quelque peu « éthérée » du numérique, donnée en partie par son ubiquité, et aussi par le vocabulaire utilisés (cloud computing, fog computing).
Visite guidée d’un centre de données et de calcul
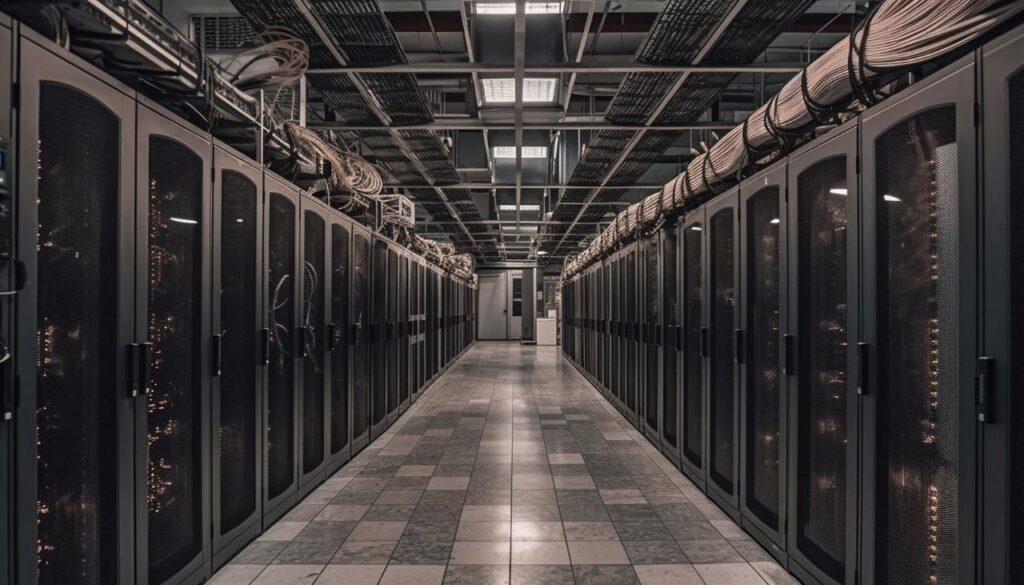
Un CDC est une installation industrielle conçue pour des opérations de stockage et de traitement de données qu’on peut décomposer en plusieurs zones :
- salles des machines abritant des serveurs, c’est-à-dire des machines physiques ou virtuelles qui exécutent des applications et stockent des données, des baies de stockage de données (cartes mémoire, disques) et des équipements de réseaux de communications (routeurs, commutateurs, câbles et équipements pour interconnecter les serveurs et assurer la connectivité externe) ;
- zones de refroidissement : climatisation, ventilation ou systèmes de refroidissement liquide pour maintenir une température optimale ;
- infrastructures électriques : pour éviter les coupures et assurer un service sans interruption 24 heures sur 24, 7 jours sur 7, des systèmes dits « redondants » assurent l’alimentation électrique (onduleurs, générateurs, batteries). La consommation d’énergie électrique s’explique par des serveurs informatiques énergivores, le refroidissement et le fonctionnement sans interruption avec des lignes électriques redondantes pour assurer une qualité de service qui peut être pondérée en fonction des usages ;
- zones des systèmes d’information, sécurité informatique (cyberattaques, fuites de données, pannes), logiciels (systèmes d’exploitation, virtualisation, gestion des données, outils de monitoring, sauvegardes et archivages…) ;
- zones logistiques : sécurité physique, contrôle d’accès, caméras, détecteurs d’incendie, etc. (logiciels, systèmes d’exploitation, virtualisation, gestion des données, outils de monitoring…) ;
- zones de vie et de travail.
Avant de pouvoir installer un CDC quelque part, tous ces sous-ensembles doivent être caractérisés avec précision, en fonction des spécificités des territoires les accueillant, car la nature des équipements, les techniques de calcul et celles de refroidissement auront un impact sur les ressources nécessaires (énergie électrique et eau) et les populations concernées.
Une taille en expansion explosive
Résumons le chemin parcouru. Notre point de départ est en 1946 : le premier ordinateur électronique, l’ENIAC, composé de relais et de tubes électroniques, d’une puissance électrique de 150 kilowatts, en gros l’équivalent de 150 aspirateurs allumés, d’un poids de 30 tonnes, pour une performance de calcul de 5 000 additions par seconde.
Dans les années 1970, les ordinateurs IBM dépassent le million d’opérations par seconde grâce aux progrès technologiques (les transistors, puis les circuits intégrés qui possèdent quelques dizaines puis quelques milliers de transistors sur un substrat de silicium).
Aujourd’hui, les progrès spectaculaires en microélectronique permettent de fabriquer des processeurs intégrant plus de 100 milliards de transistors sur des surfaces de silicium de quelques centimètres carrés, et de produire industriellement des supercalculateurs dont la complexité dépasse aujourd’hui un milliard de milliards (10¹⁸) d’opérations par seconde pour moins de 20 mégawatts de puissance électrique (soit 20 000 aspirateurs !).
Autrement dit, en huit décennies, les performances d’un supercalculateur ont été multipliées par un facteur de l’ordre de 200 000 milliards ! Ceci a permis la miniaturisation des fonctions de calcul (apparition du premier PC, des ordinateurs portables avec batteries intégrées, des tablettes, des smartphones…) et la naissance d’un monde numérique interconnecté.
Les architectures informatiques
Il est à noter que les principes d’architectures des Central Processing Unit (CPU), énoncés au siècle dernier par John von Neumann et inspirés des travaux d’Alan Turing, s’appliquent toujours.
Ils reposent sur une unité arithmétique et logique, une unité de contrôle, une zone mémoire pour stocker les données et les instructions, et enfin les entrées/sorties pour assurer la communication avec le monde extérieur. Bien entendu, les technologies et les fonctionnalités sont aujourd’hui plus performantes et conduisent à cinq niveaux superposés : les circuits intégrés englobant des unités de traitement indépendantes (les « cœurs ») ; les MCM (pour Multi Chips Module ou intégration 3D de puces silicium CPU, GPU, mémoire) ; les calculateurs et serveurs ; et, enfin, les CDC.
Les goulots d’étranglement et les limites physiques sont les mêmes pour ces différents niveaux d’intégration : gestion des espaces mémoire, communications – en particulier calculs et mémoires, parallélisme, performances en vitesse et consommation d’énergie…
Il existe plusieurs modèles de CDC, adaptés aux différents besoins en matière de sécurité, de souveraineté et de sobriété :
- les CDC gérés en interne pour ses propres besoins ;
- les CDC externalisés, en louant de l’espace dans un data center tiers pour y installer ses propres équipements ;
- les CDC cloud d’opérateurs, où les ressources sont virtualisées et accessibles à la demande ;
- les CDC dits « hyperscale » pour gérer des volumes de données massifs et, plus récemment, des baies de calculs GPU adaptés aux intelligences artificielles génératives.
Le développement massif des IA génératives bouleverse ces organisations
Les accélérateurs GPU distribuent les calculs matriciels sur des milliers d’unités (cœurs), contrairement aux CPU, limités à quelques cœurs plus complexes et aux traitements séquentiels. Dotés de mémoires intégrées très rapides, mais limitées en capacité, ils offrent ainsi un gain de performance pour les apprentissages et les inférences des IA génératives, au prix de puissances électriques de plus en plus élevées de plusieurs centaines de watts.
La dimension des matrices (ou des paramètres) dans les modèles de langage joue un rôle clé dans leurs performances et dans leurs besoins en ressources. Pour un LLM (Large Language Models) conçu pour traiter des tâches complexes de compréhension et de génération de langage, la taille est généralement mesurée en milliards de paramètres sollicitant plusieurs dizaines de milliers de GPU. Pour donner un ordre de grandeur, la multiplication de deux matrices de dimension 4096×4096, nécessite un nombre d’opérations arithmétiques de l’ordre de 68 milliards (sans optimisation).
Cette augmentation rapide du nombre de GPU pour les apprentissages et les inférences, liée à une augmentation de la densité et de la puissance électrique des circuits intégrés a pour conséquence la multiplication de projets de CDC dépassant aujourd’hui un milliard de watts de puissance électrique.
Les impacts environnementaux et sociétaux des centres de données et de calculs
Les CDC s’ajoutent ainsi aux centrales électriques, aux réseaux de transport et de communications, aux chaînes de production, et ils en dépendent.
Leur fonctionnement a des impacts environnementaux et sociétaux : ressources nécessaires pour les équipements et le fonctionnement (énergie électrique, eau), artificialisation des sols, émissions (bruit, îlots de chaleur) et rejets (groupes électrogènes diesel, gaz réfrigérants), enfin, gestion de l’obsolescence des matériels…
Les défis sont donc nombreux (sobriété énergétique, sécurité, suivi des impacts) et nécessiteront des efforts d’adaptation, de créativité, de régulation et de transparence.
Cette expansion fulgurante se heurte ainsi à des limites économiques et physiques. Comme le soulignent les actualités récentes, l’infrastructure IA progresse à un rythme que le marché peine à suivre. Selon le PDG d’IBM, équiper plus de 100 gigwatts (GW) de capacité des CDC pourrait coûter entre 6 000 milliards et 8 000 milliards de dollars. Pour rentabiliser un tel investissement, il faudrait générer des revenus à une échelle sans précédent.
À Loughton, à moins de 30 kilomètres de Londres, un autre défi se pose : trouver suffisamment d’électricité pour alimenter le méga data center IA de Nscale, d’une puissance de 90 mégawatts (MW). Le projet, déjà retardé, bute sur une contrainte simple mais critique : l’insuffisance des capacités du réseau électrique local !
Michel Robert, Professeur des Universités, Université de Montpellier
Cet article est republié à partir de The Conversation sous licence Creative Commons. Lire l’article original.